El haber realizado este blog durante el segundo cuatrimestre de mi primer año de carrera en enfermería me ha hecho aprender sobre el uso de las tecnologías actuales y sobre lo necesaria que es la estadística en la vida, y cómo no, también en la enfermería y en la investigación. Sin ellas no sería posible avanzar en calidad de vida y salud. Me ha sido muy útil el material usado para cada entrada, así como diferentes vídeos de refuerzo para una mejor comprensión de las mismas. Espero que mis entradas hayan ayudado a la gente que las ha visto y les hayan sido útiles para su aprendizaje tanto como para mí hacerlas. ¡Un saludo a todos y gracias por leerme!.
lunes, 8 de junio de 2020

BLOQUE TEMÁTICO 4. TEMA 15,16 Y 17
ÍNDICE
TEMA 15: Concepto de red de información sanitaria
- e-salud y e-bienestar: nuevos espacios virtuales para los cuidados
TEMA 16: Aplicación de las TIC en los cuidados enfermeros
- Cambio de paradigma
- Ventajas TIC en enfermería
- Desventajas TIC en enfermería
- Algunas apps en enfermería
TEMA 17: TIC, medios de comunicación social y enfermería
- Ventajas
- Desventajas
- Algunos blogs de enfermería más leídos
TEMA 15: Concepto de red de información sanitaria
1. e-salud y e-bienestar: nuevos espacios virtuales para los cuidados
La sanidad del futuro a través de las TIC da lugar a una salud conectada, empoderando al paciente. El impacto de la TIC ha revolucionado la salud (Tele consulta; Control y seguimiento enfermos crónico; Red, profesional para el intercambio de información y experiencias y Monitorización on line).
El impacto y aplicación de las TICs en centros sanitarios y de emergencia se da en centros de salud, hospitales y emergencias.
Pagliari 2005: modificación definición de e-salud de Eisenbach: La esalud es un campo emergente de la de la informática médica, refiriéndose a la organización y
prestación de servicios de salud e información a través de Internet y las tecnologías relacionadas. En
un sentido más amplio, el término caracteriza no sólo un desarrollo técnico, sino también una nueva
forma de trabajar, una actitud y un compromiso para el pensamiento global en red, con el fin de
mejorar la atención sanitaria a nivel local, regional y mundial mediante el uso de tecnologías de la
información y la comunicación.
La OMS define la cibersalud como el uso de tecnologías de la información y la comunicación (TIC) para la salud. También existe el término e-salud, que se ocupa de mejorar el flujo de información, a través de medios electrónicos,
para apoyar la prestación de servicios de salud y la gestión de los sistemas de salud. Otros términos son:
- Salud 2.0
- Salud móvil (en inglés m-health / s. health)
- Telesalud (tele-health): No sólo servicios médicos sino también intervenciones de todos los profesionales de la salud.
- Telemedicina y Teleenfermería: Años 70. Proporciona soporte clínico para mejorar resultados en salud, rompiendo barreras geográficas.
- e-pacientes
- e-profesionales
- Redes sociales y salud
- Redes de pacientes, comunidades virtuales y tecnologías de acercamiento en salud.
La salud conectada es la convergencia e integración de Internet y otras
tecnologías digitales en el ámbito de la salud. Implica el desarrollo de
competencias en el uso de herramientas tecnológicas para la mejora de la salud
propia y la de aquellas personas que nos rodean, así como una capacidad de
adaptación a los nuevos desafíos que se presentan en un entorno en constante
evolución.
TEMA 16: Aplicación de las TIC en los cuidados enfermeros
1. Cambio de paradigma
Enfermería informática: es la integración de ciencia y práctica de
enfermería, su información y conocimiento y su gestión con tecnologías de
la información y comunicación para promover la salud de las personas,
familias y comunidades a nivel mundial (IMIA-NI-2009). Es una especialidad que integra las Ciencias de la Enfermería, de la
Computación y de la Información para la identificación, recolección,
procesamiento y manejo de datos e información para el apoyo de la
investigación, educación y expansión del conocimiento, gestión y cuidado
asistencial (Sociedad Informática en Enfermería Española – 2005).
Los ámbitos de aplicación de las TIC en salud se han
venido agrupando en cuatro grandes campos: Practica clínica, Gestión , Educación / docencia, Investigación.
2. Ventajas TIC en enfermería
- Favorecer la difusión de información y la comunicación entre los diferentes miembros del equipo de salud.
- Mayor visibilidad de la enfermería
- Agilidad en toma de decisiones y aumento calidad de cuidados
- Perspectiva clínica y favoreces la investigación.
- Facilita el intercambio de información entre la enfermera y el paciente.
- Mantenimiento de la formación (formación continuada).
3. Desventajas TIC en enfermería
- Distracciones
- Dispersión
- Pérdida de tiempo
- Información no fiables
- Aprendizajes incompletos y superficiales
- Visión parcial de la realidad
- Ansiedad
- Dependencia de la personas.
4. Algunas apps en enfermería


TEMA 17: TIC, medios de comunicación social y enfermería
La esencia de nuestra profesión es “cuidar a las personas, y hoy, estas están en las redes
sociales, por lo que tenemos que estar en redes sociales”. Es una herramienta con mucho potencial para: Difundir vivencias; Visibilizar situaciones; Aprender; Compartir conocimientos.
Las Redes Sociales son otro campo profesional en el que podemos desarrollar nuestros
cuidados.
1. Ventajas
- Conectividad
- Compartir información
- Estar al día
- Creación
- Hacer visibles tus ideas
- Una identidad profesional
2. Desventajas
- Riesgo la privacidad
- Peligrosas para nuestra imagen profesional
- Mala gestión del nuestro tiempo
- Exceso de información
- Violación de nuestra ética
3. Algunos blogs de enfermería más leídos
- Ebevidencia: Azucena Santillán profesora en la Escuela Universitaria de Burgos es la persona que
lidera nuestra lista.
Todo una referente dentro de las redes sociales cuyo objetivo siempre ha sido
divulgar y fomentar la enfermería basada en evidencias(EBE). Blog Ebevidencia
- Enfermería blog: El autor y editor de este Blog y del perfil en Twiher @enfermeratweet con más de
36mil seguidores, no es otro que Jordi Mitjà Costa .
Enfermero del Área de Salud Mental del Hospital Sant Joan de Déu de Barcelona. Sus objetivos son: Difundir información basada en la evidencia científica; Apoyar a la Enfermería; Crear un espacio de reflexión y Desarrollar recursos. Enfermería blog
- Enfermería Creativa: La difusión de conocimiento a través de infogramas es cada vez más frecuente por
su formato visual, fáciles de asimilar y recordar. Por eso no es de extrañar que esté
tan de moda en las rrss. Enfermería creativa blog
- Enfermero del Pendiente: muestran los cuidados de
enfermería en UCI. Enfermero del pendiente blog
- Cuidando neonatos: blog de enfermería neonatal dirigido a
profesionales pero también a madres y padres
que buscan información sobre el tema.
Su autora, Rosario Ros, se embarcó en esta
iniciativa en el 2014 y a día de hoy es el blog
de referencia sobre las diferentes áreas de los
cuidados neonatales.
Su objetivo principal es servir de plataforma de comunicación de los
profesionales sanitarios que trabajan en esta área e impulsar las
prácticas basadas en la evidencia. Cuidando neonatos blog
BLOQUE TEMÁTICO 4: TICS Y SALUD. CUIDADOS 2.0. TEMA 14: TICS, SOCIEDAD DEL CONOCIMIENTO Y SALUD
ÍNDICE
- Sociedad de la información
- Sociedad de la comunicación
- Convergencia digital
- Definición de TICs
- TIC y gestión de la información en enfermería
1. Sociedad de la información
* Características de la Sociedad de la Información:
- Impulsar la globalización mediante el uso y desarrollo de las TIC
- Fomentar la Sociedad del Conocimiento
- Mantener libre el flujo de información y conocimiento
- Marcar a una generación, su desarrollo e identidad
- Comunicar de forma inmediata eventos o noticias de interés público
- Permitir una mayor influencia de la sociedad en decisiones políticas
- Acelerar el desarrollo económico de los países mediante la tecnología
- Eliminar la presencialidad para comunicarse, estudiar o trabajar
- Crear nuevos puestos de trabajo
- Optimizar procesos industriales obsoletos que finalmente conducen a la transformación digital
2. Sociedad de la comunicación
* ¿Qué es la sociedad del conocimiento?
La sociedad del conocimiento es aquella que se determina por el acceso y
procesamiento de la información para transformarla en conocimiento. Su valor
primordial es el aprendizaje a lo largo de la vida, que no está determinado ni por el
espacio (las instituciones de enseñanza) o el tiempo.
En la cultura de esta sociedad, la utilización de las las TICS para la investigación, la
educación, la comunicación y la vinculación social mediante redes, son algunas de las
manifestaciones más importantes.
*Características de las Sociedad del Conocimiento (David Y Foray, 2002)
- Aceleración de la producción de conocimientos.
- La innovación se convierte en la actividad dominante.
- La revolución de los instrumentos del saber.
3. Convergencia digital
- Consultar el mismo contenido en distintos dispositivos
- No siempre ha tenido el mismo significado
* Breve Historia:
- Nueva puerta a la innovación
- Evolución de los sistemas analógicos al campo digital Mayor demanda por los usuarios
- Desarrollo de la conectividad
- Continuación de tareas
- Adaptación de los dispositivos a los usos de la usuarios
* Uso y futuro de la convergencia digital
- Cambio y adaptación continua de todos los sectores profesionales
- Consumir contenido desde Internet
- Mayor inmediatez
4. Definición de TICs
TIC / TICs: Tecnologías de la Información y la Comunicación
Conjunto de recursos necesarios para tratar información a través de ordenadores y
dispositivos electrónicos, aplicaciones informáticas y redes necesarias para
convertirla, almacenarla, administrarla y transmitirla. A nivel de usuario, sea
individual o empresa, las TIC forman el conjunto de herramientas tecnológicas que
permiten un mejor acceso y clasificación de la información como medio tecnológico
para el desarrollo de su actividad.
Otros conceptos:
• NTICS: Nuevas Tecnologías de la Información y la Comunicación
• TI: Tecnologías de la Información
5. TIC y gestión de la información en Enfermería
- Situación actual (competencias enfermeras)
- La llegada de las TIC a la enfermería. Ejemplo en la
actualidad:
- Historias clínica digitales
- Aplicaciones móviles (apps)
- Teleasistencia (telealarma, telemonitorización)
BLOQUE TEMÁTICO 3. TEMA 13: PRUEBAS PARAMÉTRICAS MÁS UTILIZADAS EN ENFERMERÍA
En este tema al ser más práctico, facilito vídeos para su mejor comprensión:
T de Student (Teoría)
T de Student (Ejercicio)
Prueba ANOVA
T de Student (Teoría)
T de Student (Ejercicio)
Prueba ANOVA
BLOQUE TEMÁTICO 3. TEMA 12:CONCORDANCIA Y CORRELACIÓN
Este tema al ser práctico y más de cálculo, facilito un vídeo explicativo para su mejor comprensión:
TUTORIAL PRUEBA PARAMÉTRICA DE PEARSON
CÁLCULO DEL COEFICIENTE DE CORRELACIÓN DE SPEARMAN (Parte I)
CÁLCULO DEL COEFICIENTE DE CORRELACIÓN DE SPEARMAN (Parte II)
TUTORIAL PRUEBA PARAMÉTRICA DE PEARSON
CÁLCULO DEL COEFICIENTE DE CORRELACIÓN DE SPEARMAN (Parte I)
CÁLCULO DEL COEFICIENTE DE CORRELACIÓN DE SPEARMAN (Parte II)
BLOQUE TEMÁTICO 3. TEMA 11: PRUEBAS NO PARAMÉTRICAS MÁS UTILIZADAS EN ENFERMERÍA
ÍNDICE
- Pruebas no paramétricas Análisis bivariado de variables cualitativas: Test de hipótesis Chi-cuadrado
- Odds ratio
1. Pruebas no paramétricas Análisis bivariado de variables cualitativas: Test de hipótesis Chi-cuadrado
- Compara dos variables cualitativas (dependiente
e independiente).
- Razonamiento a seguir: suponemos la hipótesis cierta,
y estudiamos cómo es de probable que siendo iguales
los dos grupos a comparar se obtengan resultados como
los obtenidos o haber encontrado diferencias más
grandes por grupos.
* Tablas de contingencia-frecuencias absolutas
Tablas de doble entrada que se emplean para registrar y
analizar la asociación entre dos o más variables de
naturaleza cualitativa (nominales u ordinales).
Tabla de contingencia general para la
comparación de dos variables dicotómicas:

La prueba o estadístico Chi cuadrado se utiliza para
comprobar si la diferencia en los datos que observamos:
- Es debida al azar (Recordemos que la Ho establece que no hay diferencia,
es decir, que hay igualdad. Aceptamos la H0).
- Es debida a algo más, por ejemplo una asociación entre
las variables que estudiamos (Rechazamos la H0. Aceptamos la H1).
* Condiciones para aplicar la Chi cuadrado
- Las observaciones deben ser independientes.
- Utilizar en variables cualitativas.
- Más de 50 casos.
- Las frecuencias teóricas o esperadas en cada casilla de clasificación no deben ser inferiores a 5. Si son menores que 5, no podemos sacar conclusiones del contraste de hipótesis con Chi-cuadrado.
- Utilizar el estadístico de Fisher.
- Corrección de continuidad de Yates: Actualmente discutido por bastantes autores y se puede no tener en cuenta. Es una práctica muy generalizada.
- Frecuencia observada: la que recogen los datos.
- Frecuencia esperada: la que observaríamos si no hubiera
relación.
- Grados de libertad (gl): Número de valores o datos que pueden
variar libremente dado un determinado resultado.
- Grados de libertad = k -1 (número de categorías menos una)
- Grados de libertad (gl) = (filas -1)*(columnas -1) (número de filas menos una) por (número de columnas menos una).
Esta prueba permite determinar si dos variables cualitativas están o no asociadas. Es
decir si son dependientes (H1) o independientes(Ho). Para su cómputo calculamos:
- Frecuencias esperadas (FE): aquellas que deberían haberse
observado si la Ho fuese cierta, si ambas variables fueran
independientes.
- Frecuencias observadas (FO) en nuestro estudio.
Las comparamos para calcular el valor del estadístico chi cuadrado (X2):

Cuanto mayor sea la diferencia (y, por tanto, el valor del estadístico), mayor es la
asociación/dependencia entre ambas variables. Por otra parte, como las diferencias entre las frecuencias observadas y esperadas están
elevadas al cuadrado, esto hace que el valor de X2 siempre sea positivo.
Para obtener los valores esperados , éstos se calculan a través del
producto de los valores totales marginales dividido por el número total de
casos (n). Para el caso más sencillo de una tabla 2x2:

* Resumen del procedimiento
- Establecer la hipótesis nula (H0).
- Realizar una tabla con los datos observados o frecuencias
observadas (fo).
- Calcular los grados de libertad (gl).
- Calcular las frecuencias esperadas o teóricas (fe o ft).
- Utilizar el estadístico:

- Compararlo con las tablas al nivel de significación fijado.
- Aceptar o rechazar la H0.
2. Odds ratio
Permite cuantificar la importancia/fuerza de la asociación entre dos variables. Puede acompañar al resultado de la prueba chi-cuadrado (en variables dicotómicas). Es la frecuencia expuestos/frecuencia no expuestos (casos y
controles). La Odds ratio sería el cociente entre la odds del grupo de individuos de la categoría 1 de
la variable supuestamente dependiente (variable 2) (a/c), frente a la odds del otro
grupo formado por los individuos de la categoría 2 de esa misma variable (b/d).

* Características
- No tiene dimensiones.
- El rango va de 0 a ∞
- OR=1 indica que no hay asociación (independencia)
- OR>1 la presencia del factor de exposición (V1.1) se asocia a mayor ocurrencia del evento (V2.1)
- OR<1 la presencia del factor de exposición (V1.1) se asocia a menor ocurrencia del evento (V2.1)
martes, 26 de mayo de 2020
BLOQUE TEMÁTICO 3. TEMA 10: ESTIMACIÓN Y/O SIGNIFICACIÓN ESTADÍSTICA
ÍNDICE
- Significación estadística
- Contraste de hipótesis
- Errores de hipótesis
- Métodos de contraste de hipótesis
1. Significación estadística
Está relacionada con el resultado del estudio.
Así, cuando se dice que la p < 0.05, estamos afirmando que el resultado del
estudio se cumple, al menos, en el 95% de los casos. Una de las dos formas de inferencia estadística (la otra
es la estimación puntual y/o por intervalos). Permite contrastar hipótesis y relacionarlo con el método científico. Se parte de la hipótesis nula, frente a la hipótesis alternativa. Permite calcular el nivel de significación y tomar decisiones, cuantificando el error.


2. Contraste de hipótesis
Nos permite decidir si
los resultados obtenidos son fruto de la
causalidad (por una relación causa-efecto) o de
la casualidad (por azar). Son herramientas estadísticas para responder a preguntas
de investigación: permite cuantificar la compatibilidad entre
una hipótesis previamente establecida y los resultados
obtenidos. Sean cuales sean los deseos de los investigadores, el test de
hipótesis siempre va a contrastar la hipótesis nula (la que
establece igualdad entre los grupos a comparar, o lo que es lo
mismo, la no que no establece relación entre las variables de
estudio).
- La hipótesis nula (H0): no existen diferencias significativas entre los resultados obtenidos en la prac1ca y los resultados teóricos
- La hipótesis de investigación o alternativa (H1 o Ha): afirma que la media de la población es un valor diferente al hipotético.
Se utiliza la prueba estadística correspondiente y se mide la
probabilidad de error al rechazar la hipótesis nula, asociada al
valor de p. Según el nivel de significación que hayamos preestablecido
(habitualmente un 95%) las soluciones pueden ser:
- p>0,05: en este caso no podemos rechazar la hipótesis nula (no podemos decir que sea cierta, sino que no podemos rechazarla).
- p<0,05: en este caso rechazamos la hipótesis nula, por lo que debemos aceptar la hipótesis alternativa.
FASE 1
Formular nuestra hipótesis nula a partir de la hipótesis de investigación o alternativa.
• Hipótesis nula = nulas (no hay) diferencias. Normalmente se expresa de la siguiente forma, H0: μA = μB.
• Hipótesis de investigación o alterna,va (H1 o Ha) la que afirma que la media de la población es un valor diferente al hipotético. Se suele expresar de la siguiente forma, H1: μA ≠μB.
* Contraste bilateral:
Se presenta cuando la hipótesis nula es del tipo H0: μ = μ0 H0: p = p0
La hipótesis alternativa, por tanto, es del tipo H1: μ≠ μ0 H1: p≠ p0
El nivel de significación α se concentra en dos partes (o colas) simétricas respecto de la media.

* Formulación de H0: H0: μA ≤ μB (porque la H1: μA>μB)
La hipótesis nula postula entonces que B es igual de eficaz que A, lo que se expresa: H0: μA = μB


• Hipótesis nula = nulas (no hay) diferencias. Normalmente se expresa de la siguiente forma, H0: μA = μB.
• Hipótesis de investigación o alterna,va (H1 o Ha) la que afirma que la media de la población es un valor diferente al hipotético. Se suele expresar de la siguiente forma, H1: μA ≠μB.
* Contraste bilateral:
Se presenta cuando la hipótesis nula es del tipo H0: μ = μ0 H0: p = p0
La hipótesis alternativa, por tanto, es del tipo H1: μ≠ μ0 H1: p≠ p0
El nivel de significación α se concentra en dos partes (o colas) simétricas respecto de la media.

La hipótesis nula postula entonces que B es igual de eficaz que A, lo que se expresa: H0: μA = μB
FASE 2
H0 se calcula, mediante el estadístico de contraste más
apropiado, la probabilidad de que los resultados observados
puedan deberse al azar.
Un estadístico de contraste de hipótesis o de significación
estadística es una medida estandarizada de la discrepancia
que hay entre la hipótesis nula y el resultado de la diferencia
de medias obtenido en la muestra.
El estadístico de contraste se elige por:
- La escala de medida y el tipo de variables.
- La independencia o dependencia de las medidas.
- El aspecto de la distribución de la variable dependiente.
En el caso de que estos supuestos no se cumplan, se utilizan los contrastes
no paramétricos, que permiten poner a prueba hipótesis no referidas a
parámetros poblacionales (en estos casos la distribución de frecuencias de
la variable dependiente puede asemejarse a la distribución de Poisson o a la
de t de Student).

FASE 3

3. Errores de hipótesis
Con una misma muestra podemos
aceptar o rechazar la hipótesis nula,
todo depende de un error, al que llamamos α.
- El error α es la probabilidad de
equivocarnos al rechazar la hipótesis nula.
- El error tipo I que consiste en decir que existen diferencias estadísticamente
significativas (porque realmente síexisten en la muestra que se ha tomado)
cuando realmente esto no es cierto.
- El error tipo II en el que se indica que no existen diferencias (en la muestra no
se hallan diferencias estadísticamente significativas), cuando realmente esto
no es cierto. A este &po de error también se le conoce como error β.
- El error α más pequeño al que podemos rechazar H0 es el error p. Habitualmente rechazamos H0 para un nivel α
máximo del 5% (p<0,05). Es lo que llamamos “significación estadística”.
* Tipos de errores en test de hipótesis


4. Método de contraste de hipótesis
PASO 1
Expresar el interrogante de la investigación como una hipótesis estadística:
- H0: No hay diferencia
- H1: Hay diferencia
PASO 2
Decidir sobre la prueba estadística adecuada según la población y el tipo de variables.
* Tipos de análisis estadísticos según el tipo de variables implicadas en el estudio

PASO 3
Seleccionar el grado de significación para la prueba estadística. El grado de significación = alfa= probabilidad de rechazar de manera incorrecta H0 cuando sea cierta (normalmente 0.05, 0.01, 0.001).
PASO 4
Realizar los cálculos y exponer conclusiones.
lunes, 25 de mayo de 2020
BLOQUE TEMÁTICO 3: ANÁLISIS DE DATOS II: INFERENCIA Y ESTIMACIÓN DE DATOS CUANTITATIVOS Y CUALITATIVOS. TEMA 9: INTRODUCCIÓN A LA INFERENCIA ESTADÍSTICA. INTERVALOS DE CONFIANZA Y CONTRASTES DE HIPÓTESIS
ÍNDICE
- Inferencia estadística
- Estimación puntual
- Error estándar
- Teorema central del límite
- Intervalos de confianza
- Contraste de hipótesis
1. Estadística inferencial


Es el conjunto de procedimientos estadísticos que permiten pasar de lo
particular, la muestra, a lo general, la población.
- Población: Conjunto de personas, sujetos o unidades que presentan una característica
común. Puede ser finita o infinita.
- Muestra: Subconjunto extraído y seleccionado de una población a la que representa.
- Muestra: Subconjunto extraído y seleccionado de una población a la que representa.
- Muestra Independiente: Está formada por datos independientes, o sea, aquellos obtenidos tras una única observación.
- Muestra apareada o dependiente: Está constituida por datos apareados (también llamados dependientes o emparejados). Comparan el mismo grupo de sujetos en dos tiempos diferentes (por ejemplo antes y después de una intervención), o bien son grupos muy relacionados entre sí.
Hay 2 formas de inferencia estadística:
- ESTIMACIÓN: Parámetro - - Estimador
- Estadístico o Estimador: Índice que representa una información de la muestra estudiada. Suelen expresarse mediante letras del alfabeto latino. Propiedades deseables: Insesgadez, Eficiente, Consistencia.
- Parámetro: Cada uno de los estadísticos que tras inferirse, nos proporcionan información sobre la población. A diferencia de los estadísticos, éstos se representan mediante letras del alfabeto griego.

- CONTRASTE DE HIPÓTESIS


2. Estimaciones
Proceso de utilizar información de una muestra para extraer
conclusiones acerca de toda la población. Se utiliza la información recogida para estimar un valor. Puede realizarse:
- Estimación puntual: Consiste en considerar al valor del estadístico muestral como una estimación del parámetro poblacional. Significa manejo de incertidumbre e imprecisión.

- Estimación por intervalos: Consiste en calcular dos valores entre los cuales se encuentra el parámetro poblacional que queremos estimar con una probabilidad determinada, habitualmente el 95%. Se pueden crear para cualquier parámetro de la población. Se utilizan como indicadores de la variabilidad de las estimaciones. Cuanto más “estrecho” sea, mejor.

- Cálculo de intervalos de confianza (explicado más abajo)
3. Error estándar
Es la medida que trata de captar la variabilidad de los valores del
estimador. El error estándar de cualquier estimador mide el grado de
variabilidad en los valores del estimador en las distintas muestras
de un determinado tamaño que pudiésemos tomar de una
población. Cuanto más pequeño es el error estándar de un estimador, más nos
podemos fiar del valor de una muestra concreta.
* Cálculo del error estándar
Depende de cada estimador.
- Error estándar para una media:

- Error estándar para una proporción: se aplica cuando las variables del estudio son
cualitativas o atributos, en consecuencia no podemos
cuantificarlos para obtener su media aritmética.

P es el porcentaje o proporción a estimar.
4. Teorema central del límite
Para estimadores que pueden ser expresados como
suma de valores muestrales, la distribución de sus
valores sigue una distribución normal con media de
la de la población y desviación típica igual al error
estándar del estimador de que se trate. Si sigue una distribución normal, sigue los principios
básicos de ésta:
– ± 1S: 68,26% de las observaciones
– ± 2S: 95,45% de las observaciones
– ± 1,95S: 95% de las observaciones
– ± 3S: 99,73% de las observaciones
– ± 2,58S: 99% de las observaciones
5. Intervalos de confianza
Son un medio de conocer el parámetro en una población midiendo el
error que tiene que ver con el azar (error aleatorio). Se trata de un par de números tales que, con un nivel de
confianza determinados, podamos asegurar que el valor del
parámetro es mayor o menor que ambos números. Se calcula considerando que el estimador muestral sigue una
distribución normal, como establece la teoría central del límite
Para construir un intervalo de
confianza del 95% o del 99%
se aplica la fórmula:

Para nivel de confianza 95% z=1,96
Para nivel de confianza 99% z=2,58
(Z es un valor que depende del nivel de confianza 1-a
con que se quiera dar el intervalo)
6. Contrastes de hipótesis
Para controlar los errores aleatorios, además del
cálculo de intervalos de confianza, contamos con una
segunda herramienta en el proceso de inferencia
estadística: los tests o contrastes de hipótesis. Con los intervalos nos hacemos una idea de un
parámetro de una población dando un par de números
entre los que confiamos que esté el valor desconocido. Con los contrastes (tests) de hipótesis la estrategia es
la siguiente:
- Establecemos a priori una hipótesis acerca del valor del
parámetro.
- Realizamos la recogida de datos.
- Analizamos la coherencia de entre la hipótesis previa y los
datos obtenidos.
BLOQUE TEMÁTICO 2. TEMA 8: TEORÍA DE MUESTRAS
ÍNDICE
- Estimación e inferencia estadística
- Procedimiento muestral
- Tipos de muestreo
- Tamaño de la muestra
1. Estimación e inferencia estadística
El el conjunto de procedimientos que permiten elegir muestras
de tal forma que éstas reflejen las características de la
población le llamamos técnicas de muestreo. Siempre que trabajamos con muestras (no estudiamos el
problema en toda la población sino en una parte de ella) hay
que asumir un cierto error. Si la muestra se elige por un procedimiento de azar, se puede
evaluar ese error. La técnica de muestreo en ese caso se
denomina muestreo probabilístico o aleatorio y el error
asociado a esa muestra elegida al azar se llama error
aleatorio En los muestreos no probabilísticos no es posible evaluar el
error. En los muestreos probabilísticos, el error aleatorio es
inevitable pero es evaluable.

2. Procedimiento muestral
Un muestreo es un método tal que al escoger un
grupo pequeño de una población podamos tener un
grado de probabilidad de que ese pequeño grupo
posea las características de la población que
estamos estudiando.
3. Tipos de muestreo
- Muestreo Probabilístico: Todas las unidades que
componen la población tienen una probabilidad de ser
elegidas y se puede calcular de antemano. Hay 3 tipos:
- Muestreo Aleatorio: Como su propio nombre indica, en la selección de los sujetos interviene el azar. Hay 2 tipos: Simple: seleccionar al azar (tabla numero / pc) la n (muestra). Se usa poblaciones pequeñas. El más representativo, pero tiene desventajas: listados todas las unidades / costos por dispersión población / grupos minoritarios no representados. Sistemático: seleccionar individuos según una regla o proceso. En los sistemáticos la ventaja es que no hace falta tener la lista completa.
- Muestreo Estratificado: Se utiliza cuando la característica objeto de estudio no se distribuye de forma homogénea en la población y puede afectar a los resultados del estudio, pero existen grupos o estratos donde se si presenta de manera homogénea. Estos grupos tienen alguna característica en común pero son mutuamente excluyentes. Su ventaja es conocer como se comporta una variable en cada subgrupo de la población con precisión, pero también presenta una desventaja: necesita mas información y un listado de cada individuo de la población.
- Muestreo Conglomerados: Se obtiene de grupos o conglomerados ya establecidos cuando no hay listado de la población. Se usa en poblaciones muy dispersas o no hay listado completo individuos pero si de los grupos (unidades de un hospital). Su desventaja es que no se conoce de antemano el tamaño de la muestra que se va a obtener ya que el tamaño depende de los grupos seleccionados. Necesita un mayor tamaño de la muestra para ser preciso. Las inferencias que se hacen en una muestra conglomerada no son tan confiables como las que se obtienen en un estudio hecho por muestreo aleatorio debido a que no son realmente homogéneas.
- Muestreo Consecutivo: El más utilizado. Si se hace bien puede ser la representatividad de la muestra puede ser semejan al del muestreo probabilístico. Se recluta a todos los individuos de una población que son accesibles y que cumplen los criterios de inclusión durante un periodo de reclutamiento fijado. Presenta 2 desventajas: Que no se haga de forma enteramente consecutiva sino que haya interrupciones, y que el periodo de reclutamiento corto o que haya fluctuaciones.
- Muestreo de conveniencia o accidental: Se recluta a los individuos que son mas accesibles para el equipo investigador o que se presentan voluntariamente. Se usa con frecuencia al ser el menos costoso y mas fácil. Su desventaja es que es poco sólida ya que requiere de una gran homogeneidad de la variable estudiada en la población. Genera sesgos importantes.
- Muestreo intencional o a criterio: El propio investigador es quien selecciona a los individuos al considerarlo los mas apropiados. Se usa cuando se quiere contar con una muestra de expertos o en estudios cualitativos. Su desventaja es que puede no contar con un método externo y objetivo para valorar la idoneidad de los sujetos.
- Muestreo bola de nieve, de avalancha o muestreo en cadena: El propio investigador elige a un participante que cumpla los criterios de inclusión y al mismo tiempo se le pide que identifique a otros individuos con sus mismas características para invitarles a participar y así sucesivamente hasta que se tenga recogida la muestra. Muy utilizada en estudios cualitativos. Tiene la gran ventaja de que se puede acceder a parte la población con difícil acceso o difíciles de identificar (poblaciones marginadas como sectas), pero también presenta 2 desventajas: La muestra puede ser reducida debido a la reducida red de contactos, y la calidad de los participantes condicionada por la invitación de otros a confiar en el investigador.
- Muestreo teórico: la selección de la muestra se hace de forma gradual debido a que el propósito del estudio es la generación de una teoría o porque la integración de la muestra se va diciendo sobre la marcha. Los participantes deben cubrir todas las características, perfiles y patrones que puedan influir de el fenómeno estudiado.
4. Tamaño de la muestra
Va a depender de:
- El error aleatorio (estándar)
- De la mínima diferencia entre los grupos
de comparación que se considera
importante en los valores de la variable a
estudiar
- De la variabilidad de la variable a estudiar
(varianza en la población)
- El tamaño de la población de estudio
El cálculo del tamaño de una muestra para estimar la media de una población:

- Z es un valor que depende del nivel de confianza 1-a
con que se quiera dar a los intervalos calculados a
partir de estimadores de esa muestra (Para nivel de
confianza 95% z=1,96 y para nivel de confianza 99%
z=2,58)
- S^2 es la varianza poblacional
- e es el error máximo aceptado por los investigadores
en las diferencias entre los grupos de comparación de
la variable a estudiar
- Si tras esta operación se cumple el resultado: N > n (n1), el cálculo del tamaño muestral termina aquí
- Si no se cumple, obtendremos el tamaño de la muestra
con esta fórmula: n´= n / 1+(n/N)
Para calcular el tamaño de una muestra cuando
queremos estimar una proporción:

- p es la proporción de una categoría de la variable
- 1-p es la proporción de la otra categoría
- z es el valor que depende del nivel de confianza 1-alfa
- N es el tamaño de la población
- e es el error máximo aceptado por los investigadores en
las diferencias entre los grupos de comparación de la
variable a estudiar
domingo, 24 de mayo de 2020
BLOQUE TEMÁTICO 2. TEMA 7: TEORÍA DE LA PROBABILIDAD
ÍNDICE
- Probabilidad
- Probabilidad subjetiva o personalística
- Probabilidad clásica o "a priori"
- Ley de los grandes números
- Probabilidad relativa o "a posteriori"
- Eventos o sucesos
- Reglas básicas: Teoría de la Probabilidad
- Probabilidad condicionada
- Teorema de Bayes
- Distribución binomial
- Distribución de Poisson
- Distribuciones normales
1. Probabilidad
Si no existe la certeza de que ocurran los hechos, existe una
esperanza dimensionada y razonable, de que el hecho anunciado se vea confirmado: esto es conocido como probabilidad. Se expresa mediante un número entre 0 y 1 (o en porcentajes). Esta estimación sobre la probabilidad de ocurrencia del evento nos ayuda a
tomar decisiones y por tanto a tomar decisiones al disminuir la incertidumbre y el riesgo
de equivocarnos. Cuanto más probable es que ocurre un evento, su medida de ocurrencia estará más
próximo a 1 o al 100% y cuanto menos probable, más se aproxima al cero. Aunque el concepto es simple, ya que se usa de manera intuitiva, su definición
es complicada y tiene tres vertientes:

2. Probabilidad subjetiva o personalística
La probabilidad mide la confianza que el individuo tiene sobre la
certeza de una proposición determinada. Este concepto de las probabilidades ha dado lugar al enfoque de
análisis de datos estadísticos llamado “Estadística Bayesiana”.
Data del siglo XVIII (Laplace, Pascal, Fermat), desarrollada para
resolver problemas relacionados con los juegos de azar (dados,
monedas, ruletas…). Las probabilidades se calculan con un razonamiento abstracto.
3. Probabilidad clásica o "a priori"
Si un evento puede ocurrir de N formas, las cuales se
excluyen mutuamente y son igualmente probables, y si m de
esos eventos poseen una característica E, la probabilidad de
ocurrencia de E es igual a m/N.


4. Ley de los grandes números
La probabilidad a priori de que salga un número en el dado
1
6 es P(A) = = 0,166 = 16,6 %
Inicialmente esa probabilidad real puede no cumplirse pero
si repetimos muchas veces el experimento, la frecuencia
relativa de un suceso A, cualquiera, tiende a estabilizarse
en torno al valor “a priori”.

5. Probabilidad relativa o "a posteriori"
Si un suceso es repetido un GRAN número de veces, y si
algún evento resultante, con la característica E, ocurre m veces, la
frecuencia relativa de la ocurrencia E, m/n, es aproximadamente igual a
la probabilidad de ocurrencia de E.

(Si n es suficientemente grande)
Por lo tanto, si el número de determinaciones (repeticiones de
un experimento aleatorio) es grande, podemos esperar que la
probabilidad observada se acerque a la probabilidad teórica.
6. Eventos o sucesos
Cuando se realiza un experimento aleatorio diversos resultados son posibles. El conjunto de todos los resultados posibles se llama espacio muestral (S). Se llama suceso o evento: a un subconjunto de dichos resultados. Hay 3 tipos:
- Evento complementario de un suceso A, formado por los elementos que no están en A y se denota Ac.
- Evento unión de A y B, formado por los elementos que están en A o en B (incluyendo todos los que están en ambos).
- Evento intersección de A y B, formado por los elementos que están en A y B.


- Sucesos independientes: lanzar dos dados, tener 20 años y los ojos azules
- Sucesos dependientes (ej): extraer dos cartas de una baraja sin reposición, por ejemplo ser mujer y sufrir cáncer de mama.
- Sucesos compatibles: tienen algún suceso elemental común.
- Sucesos incompatibles o excluyentes: ningún suceso elemental común (A y B son contrarios).

- Unión de sucesos: es el suceso formado por todos los elementos de A y de B.

- Intersección de sucesos: es el suceso formado por todos los elementos que son, a la vez, de A y B.
7. Reglas básicas: Teoría de la Probabilidad
- Las probabilidades de un evento o suceso siempre oscilan entre 0 y 1
- La probabilidad de que un evento o suceso sea seguro es = a 1
- La probabilidad de un suceso o evento imposible es = 0
- La unión de A y B es:
– P(AUB)=P(A)+P(B)-P(A П B)
- La probabilidad de un suceso contrario o del complemento es igual a
1 menos la probabilidad del suceso
– P (A´)= 1-P(A)
- La probabilidad de que ocurra el suceso A si ha ocurrido el suceso B
se denomina probabilidad condicionada I y se define:


8. Probabilidad condicionada
Es la probabilidad de que ocurra un evento A, sabiendo que también sucede otro evento B. La probabilidad condicional se escribe P(A|B) o P(A/B), y se lee «la probabilidad de A dado B». No tiene por qué haber una relación causal o temporal entre A y B. A puede preceder en el tiempo a B, sucederlo o pueden ocurrir simultáneamente. A puede causar B, viceversa o pueden no tener relación causal. Las relaciones causales o temporales son nociones que no pertenecen al ámbito de la probabilidad. Pueden desempeñar un papel o no, dependiendo de la interpretación que se le dé a los eventos. El condicionamiento de probabilidades puede lograrse aplicando el teorema de Bayes.

9. Teorema de Bayes
Expresa la probabilidad condicional de un evento aleatorio A dado B
en términos de la distribución de probabilidad condicional del evento
B dado A y la distribución de probabilidad marginal de sóloA.
En términos más generales el teorema de Bayes que vincula la
probabilidad de A dado B con la probabilidad de B dado A.

10. Distribución binomial
Es un modelo matemático de
distribución teórica de (la normal es con variables continuas)
variables discretas:
- Cuando se producen situaciones en las que sólo existen dos
posibilidades (cara/cruz; sano/enfermo…).
- El resultado obtenido en cada prueba es independiente de los
resultados obtenidos anteriormente.
- La probabilidad del suceso A es constante, la representamos por p, y
no varía de una prueba a otra.
- La probabilidad de `A es 1- p y la
representamos por q .
- El experimento consta de un número n de pruebas.
Mediante esta distribución se resuelven los problemas que
plantean: Si al hacer un experimento hay una probabilidad p de que ocurra un
suceso ¿Cuál es la probabilidad de que en N experimentos el suceso
ocurra X veces?
- P: probabilidad de ocurrencia; q de no ocurrencia
- X: número sucesos favorables
- N: número total de ensayos

11. Distribución de Poisson
La distribución de Poisson se utiliza en situaciones donde los sucesos son impredecibles o de ocurrencia aleatoria (no se sabe el el total de posibles resultados). Permite determinar la probabilidad de ocurrencia de un suceso con resultado discreto (variable discreta). Es muy útil cuando la muestra o segmento n es grande y la probabilidad de éxitos p es pequeña. Se utiliza cuando la probabilidad del evento que nos interesa se distribuye dentro de un segmento n dado. También se llama la distribución de probabilidad
de casos raros.

12. Distribuciones normales

* Tipificación de valores en una normal:
Extrapolando aparecen los principios básicos de
las distribuciones normales y podemos tipificar
valores de una normal:
– ± 1S: 68,26% de las observaciones
– ± 2S: 95,45% de las observaciones
– ± 1,95S: 95% de las observaciones
– ± 3S: 99,73% de las observaciones
– ± 2,58S: 99% de las observaciones
La tipificación de la valores se puede realizar sí …
- Trabajamos con una variables continuas que:
- Sigue una distribución normal (TLC)
- Y tiene más de 100 unidades (LGN)
- La tipificación nos permite conocer si otro
valor corresponde o no a esa distribución de
frecuencia

Sabemos por la forma de la curva que la media coincide con lo más alto de la campana (8) y que la desviación típica es de 2 puntos
– El 50% tiene puntuaciones>8
– El 50% tiene puntuaciones<8
– Aproximadamente el 68% puntúa entre 6 y 10
- Media +/- 1 desviación típica: 68%
- Media +/- 2 desviación típica: 95%
- Media +/- 3 desviación típica: 99%
lunes, 18 de mayo de 2020
BLOQUE TEMÁTICO 2. TEMA 6: REPRESENTACIÓN GRÁFICA DE LA INFORMACIÓN
ÍNDICE
- Representaciones gráficas
- Representaciones gráficas más empleadas
1. Representaciones gráficas
- Forma rápida de comunicar información numérica (frecuencias).
- Son la imagen de las ideas (barras, histogramas, sectores...).
- Complementan el análisis estadístico, aumentando la información y
ofreciendo orientación visual.
- No reemplaza a las medidas estadísticas que deben ser calculadas.
- Normas básicas:
- Visualmente claros.
- Claramente descritos en pie de figura y en texto.
- Representar gráficamente las conclusiones del estudio.
- Evitar gráficos confusos, no sobrecargarlos.
2. Representaciones gráficas más empleadas
- VARIABLES CUALITATIVAS:
- Gráfico de sectores (dicotómicas o policotómicas con pocas categorías): El área de cada sector circular es proporcional a la frecuencia (absoluta o relativa) de las categorías de la variable. No se usa con variables ordinales. No es recomendable para más de 3 ó 4 categorías. Sólo muestra una variable a la vez. Si se quiere hace comparaciones se tienen que hacer dos diagramas de sectores.

- Gráfico de barras (policotómicas): Se usa también en variables cualitativa Ordinales con este tipo de gráficos evitamos que se pierda los atributos de orden o jerarquía. Las frecuencias absolutas o relativas de todas las categorías de una variable cualitativa se muestran fácilmente con este tipo de gráfico. Cada barra representa una categoría y su altura la frecuencia (absoluta o relativa). Las barras deben estar separadas. Es importante que el eje Y empiece en la frecuencia 0.

- Pictogramas (policotómicas): Es un tipo de gráfico, que en lugar de barras, utiliza figuras proporcionales a la frecuencia. Generalmente se emplea para representar variables cualitativas. Este tipo de gráfico no permite buenas comparaciones. Para realizar su gráfica primero se deben escoger las figuras que sean alusivas al tema y se les asigna un valor. En caso de que una cantidad represente un valor menor, la figura aparecerá desvirtuada.

- VARIABLES CUANTITATIVAS:
- Gráfico de barras (sólo para variables discretas con bajo rango de valores).
- Histogramas (variables continuas): El mas usado porque sencillo de interpretar. Sucesión de rectángulos contiguos construidos sobre una recta. Representa a una variable continua con sus datos agrupados en intervalos. La base de cada rectángulo representa la amplitud de cada intervalo y la altura está determinada por la frecuencia. Cada intervalo representado en el histograma ocupa un rectángulo. Es igual que diagrama de barras en cuanto al tipo de frecuencias que se pueden utilizar, la diferencia es que es para variables continuas. Si la amplitud del intervalo es la misma, elevaremos columnas unidas, a altura la frecuencia correspondiente. Si la amplitud del intervalo es diferente, el área del rectángulo columna será proporcional a la frecuencia representada.

- Polígonos de frecuencia (variables continuas): Une los puntos medios de las bases superiores de los rectángulos. Se acostumbra a prolongar el polígono hasta puntos de frecuencia cero. Un polígono de frecuencia permite ver con gran claridad las variaciones de la frecuencia de una clase a otra. Son muy útiles cuando se pretende comparar dos o más distribuciones, ya que, así como es difícil representar dos o más histogramas en un mismo gráfico, resulta muy sencillo hacerlo con dos o más polígonos de frecuencias. La suma de las áreas de los rectángulos de un histograma es igual al área limitada por el polígono de frecuencias y el eje X. El polígono de frecuencias resume, en una sola línea, el resultado del histograma correspondiente.
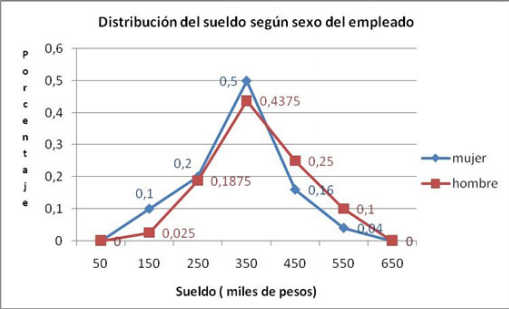
Los histogramas y los polígonos de frecuencia pueden representarse en una misma gráfica:

- Gráfico de tronco y hojas (variables continuas): Representación de la variable cuantitativa continua (ejemplo Talla). En la primera columna se representan los tallos (que corresponden en nuestro caso al primer dígito). En la segunda las hojas (en este caso el segundo dígito). Es un diagrama híbrido entre una tabla (información ordenada) y una gráfica (parecida al histograma). Tiene la ventaja de no perder información individual, identifica la distribución de los datos (posible media y mediana) y si existen clases faltantes. Esto hace que para muchos autores sea la representación gráfica de elección. Es un híbrido entre tabla e histograma: nos muestra la forma de la distribución y los valores de la variable. Cada dato de la serie se divide en dos partes: el tronco (decenas) y la hoja (unidades).

- Tendencias temporales


- Nubes de puntos (scatter plot): Para representar el comportamiento de dos variables continuas en un grupo de individuos. En el eje “x” se representa la variable independiente y en el eje “y” los valores de la variable dependiente. La imagen del diagrama nos da una posible idea de la correlación entre las dos variables.

La correlación de los puntos puede ser:

- Otros gráficos multidimensionales (diagramas de estrellas…): Para representar un conjunto de variables cuantitativas y comparar entre diferentes unidades de análisis (individuos o conglomerados). ü Cada variable representa un vértice del diagrama de estrella . Gráficamente da una idea del comportamiento conjunto de las variables estudiadas. También permite comparativas con un “gold standard”.

Suscribirse a:
Entradas (Atom)