domingo, 24 de mayo de 2020

BLOQUE TEMÁTICO 2. TEMA 7: TEORÍA DE LA PROBABILIDAD

ÍNDICE
  1. Probabilidad
  2. Probabilidad subjetiva o personalística
  3. Probabilidad clásica o "a priori"
  4. Ley de los grandes números
  5. Probabilidad relativa o "a posteriori"
  6. Eventos o sucesos
  7. Reglas básicas: Teoría de la Probabilidad
  8. Probabilidad condicionada
  9. Teorema de Bayes
  10.  Distribución binomial
  11.  Distribución de Poisson
  12. Distribuciones normales
1. Probabilidad
Si no existe la certeza de que ocurran los hechos, existe una esperanza dimensionada y razonable, de que el hecho anunciado se vea confirmado: esto es conocido como probabilidad. Se expresa mediante un número entre 0 y 1 (o en porcentajes). Esta estimación sobre la probabilidad de ocurrencia del evento nos ayuda a tomar decisiones y por tanto a tomar decisiones al disminuir la incertidumbre y el riesgo de equivocarnos. Cuanto más probable es que ocurre un evento, su medida de ocurrencia estará más próximo a 1 o al 100% y cuanto menos probable, más se aproxima al cero. Aunque el concepto es simple, ya que se usa de manera intuitiva, su definición es complicada y tiene tres vertientes:

2. Probabilidad subjetiva o personalística
La probabilidad mide la confianza que el individuo tiene sobre la certeza de una proposición determinada. Este concepto de las probabilidades ha dado lugar al enfoque de análisis de datos estadísticos llamado “Estadística Bayesiana”.
Data del siglo XVIII (Laplace, Pascal, Fermat), desarrollada para resolver problemas relacionados con los juegos de azar (dados, monedas, ruletas…). Las probabilidades se calculan con un razonamiento abstracto.

3. Probabilidad clásica o "a priori"
Si un evento puede ocurrir de N formas, las cuales se excluyen mutuamente y son igualmente probables, y si m de esos eventos poseen una característica E, la probabilidad de ocurrencia de E es igual a m/N. 


4. Ley de los grandes números
La probabilidad a priori de que salga un número en el dado 1 6 es P(A) = = 0,166 = 16,6 % Inicialmente esa probabilidad real puede no cumplirse pero si repetimos muchas veces el experimento, la frecuencia relativa de un suceso A, cualquiera, tiende a estabilizarse en torno al valor “a priori”. 
5. Probabilidad relativa o "a posteriori"
Si un suceso es repetido un GRAN número de veces, y si algún evento resultante, con la característica E, ocurre m veces, la frecuencia relativa de la ocurrencia E, m/n, es aproximadamente igual a la probabilidad de ocurrencia de E. 
(Si n es suficientemente grande)

Por lo tanto, si el número de determinaciones (repeticiones de un experimento aleatorio) es grande, podemos esperar que la probabilidad observada se acerque a la probabilidad teórica.


6. Eventos o sucesos
Cuando se realiza un experimento aleatorio diversos resultados son posibles. El conjunto de todos los resultados posibles se llama espacio muestral (S). Se llama suceso o evento: a un subconjunto de dichos resultados. Hay 3 tipos: 
  • Evento complementario de un suceso A, formado por los elementos que no están en A y se denota Ac. 
  • Evento unión de A y B, formado por los elementos que están en A o en B (incluyendo todos los que están en ambos).
  • Evento intersección de A y B, formado por los elementos que están en A y B. 

* Tipos de sucesos:

  • Sucesos independientes: lanzar dos dados, tener 20 años y los ojos azules
  • Sucesos dependientes (ej): extraer dos cartas de una baraja sin reposición, por ejemplo ser mujer y sufrir cáncer de mama.
  • Sucesos compatibles: tienen algún suceso elemental común.
  • Sucesos incompatibles o excluyentes: ningún suceso elemental común (A y B son contrarios).

  • Unión de sucesos: es el suceso formado por todos los elementos de A y de B.

  • Intersección de sucesos: es el suceso formado por todos los elementos que son, a la vez, de A y B.
7. Reglas básicas: Teoría de la Probabilidad
- Las probabilidades de un evento o suceso siempre oscilan entre 0 y 1
- La probabilidad de que un evento o suceso sea seguro es = a 1
- La probabilidad de un suceso o evento imposible es = 0
- La unión de A y B es: – P(AUB)=P(A)+P(B)-P(A П B) 
- La probabilidad de un suceso contrario o del complemento es igual a 1 menos la probabilidad del suceso – P (A´)= 1-P(A) 
- La probabilidad de que ocurra el suceso A si ha ocurrido el suceso B se denomina probabilidad condicionada I y se define: 

8. Probabilidad condicionada
Es la probabilidad de que ocurra un evento A, sabiendo que también sucede otro evento B. La probabilidad condicional se escribe P(A|B) o P(A/B), y se lee «la probabilidad de A dado B». No tiene por qué haber una relación causal o temporal entre A y B. A puede preceder en el tiempo a B, sucederlo o pueden ocurrir simultáneamente. A puede causar B, viceversa o pueden no tener relación causal. Las relaciones causales o temporales son nociones que no pertenecen al ámbito de la probabilidad. Pueden desempeñar un papel o no, dependiendo de la interpretación que se le dé a los eventos. El condicionamiento de probabilidades puede lograrse aplicando el teorema de Bayes.

9. Teorema de Bayes
Expresa la probabilidad condicional de un evento aleatorio A dado B en términos de la distribución de probabilidad condicional del evento B dado A y la distribución de probabilidad marginal de sóloA. En términos más generales el teorema de Bayes que vincula la probabilidad de A dado B con la probabilidad de B dado A.

10. Distribución binomial
Es un modelo matemático de distribución teórica de (la normal es con variables continuas) variables discretas:
- Cuando se producen situaciones en las que sólo existen dos posibilidades (cara/cruz; sano/enfermo…). 
- El resultado obtenido en cada prueba es independiente de los resultados obtenidos anteriormente. 
- La probabilidad del suceso A es constante, la representamos por p, y no varía de una prueba a otra.
- La probabilidad de `A es 1- p y la representamos por q .
- El experimento consta de un número n de pruebas.
Mediante esta distribución se resuelven los problemas que plantean: Si al hacer un experimento hay una probabilidad p de que ocurra un suceso ¿Cuál es la probabilidad de que en N experimentos el suceso ocurra X veces? 
  • P: probabilidad de ocurrencia; q de no ocurrencia 
  • X: número sucesos favorables 
  • N: número total de ensayos


11. Distribución de Poisson
La distribución de Poisson se utiliza en situaciones donde los sucesos son impredecibles o de ocurrencia aleatoria (no se sabe el el total de posibles resultados). Permite determinar la probabilidad de ocurrencia de un suceso con resultado discreto (variable discreta). Es muy útil cuando la muestra o segmento n es grande y la probabilidad de éxitos p es pequeña. Se utiliza cuando la probabilidad del evento que nos interesa se distribuye dentro de un segmento n dado. También se llama la distribución de probabilidad de casos raros.

12. Distribuciones normales

* Tipificación de valores en una normal:
Extrapolando aparecen los principios básicos de las distribuciones normales y podemos tipificar valores de una normal: 
– ± 1S: 68,26% de las observaciones
– ± 2S: 95,45% de las observaciones
– ± 1,95S: 95% de las observaciones
– ± 3S: 99,73% de las observaciones 
– ± 2,58S: 99% de las observaciones

La tipificación de la valores se puede realizar sí … 
- Trabajamos con una variables continuas que: 
  • Sigue una distribución normal (TLC) 
  • Y tiene más de 100 unidades (LGN) 

- La tipificación nos permite conocer si otro valor corresponde o no a esa distribución de frecuencia
Sabemos por la forma de la curva que la media coincide con lo más alto de la campana (8) y que la desviación típica es de 2 puntos
– El 50% tiene puntuaciones>8
– El 50% tiene puntuaciones<8
– Aproximadamente el 68% puntúa entre 6 y 10
  • Media +/- 1 desviación típica: 68%
            – 8+/-1: 6-10
  • Media +/- 2 desviación típica: 95% 
           – 4-12
  • Media +/- 3 desviación típica: 99%
          – 2-14

lunes, 18 de mayo de 2020

BLOQUE TEMÁTICO 2. TEMA 6: REPRESENTACIÓN GRÁFICA DE LA INFORMACIÓN

ÍNDICE
  1. Representaciones gráficas
  2. Representaciones gráficas más empleadas

1. Representaciones gráficas
- Forma rápida de comunicar información numérica (frecuencias).
- Son la imagen de las ideas (barras, histogramas, sectores...).
- Complementan el análisis estadístico, aumentando la información y ofreciendo orientación visual.
- No reemplaza a las medidas estadísticas que deben ser calculadas.
- Normas básicas: 
  • Visualmente claros.
  • Claramente descritos en pie de figura y en texto.
  • Representar gráficamente las conclusiones del estudio. 
  • Evitar gráficos confusos, no sobrecargarlos.
2. Representaciones gráficas más empleadas
- VARIABLES CUALITATIVAS: 
  • Gráfico de sectores (dicotómicas o policotómicas con pocas categorías): El área de cada sector circular es proporcional a la frecuencia (absoluta o relativa) de las categorías de la variable. No se usa con variables ordinales. No es recomendable para más de 3 ó 4 categorías. Sólo muestra una variable a la vez. Si se quiere hace comparaciones se tienen que hacer dos diagramas de sectores.

  • Gráfico de barras (policotómicas): Se usa también en variables cualitativa Ordinales con este tipo de gráficos evitamos que se pierda los atributos de orden o jerarquía. Las frecuencias absolutas o relativas de todas las categorías de una variable cualitativa se muestran fácilmente con este tipo de gráfico. Cada barra representa una categoría y su altura la frecuencia (absoluta o relativa). Las barras deben estar separadas. Es importante que el eje Y empiece en la frecuencia 0. 

  • Pictogramas (policotómicas): Es un tipo de gráfico, que en lugar de barras, utiliza figuras proporcionales a la frecuencia. Generalmente se emplea para representar variables cualitativas. Este tipo de gráfico no permite buenas comparaciones. Para realizar su gráfica primero se deben escoger las figuras que sean alusivas al tema y se les asigna un valor. En caso de que una cantidad represente un valor menor, la figura aparecerá desvirtuada.


- VARIABLES CUANTITATIVAS: 
  • Gráfico de barras (sólo para variables discretas con bajo rango de valores). 
  • Histogramas (variables continuas): El mas usado porque sencillo de interpretar. Sucesión de rectángulos contiguos construidos sobre una recta. Representa a una variable continua con sus datos agrupados en intervalos. La base de cada rectángulo representa la amplitud de cada intervalo y la altura está determinada por la frecuencia. Cada intervalo representado en el histograma ocupa un rectángulo. Es igual que diagrama de barras en cuanto al tipo de frecuencias que se pueden utilizar, la diferencia es que es para variables continuas. Si la amplitud del intervalo es la misma, elevaremos columnas unidas, a altura la frecuencia correspondiente. Si la amplitud del intervalo es diferente, el área del rectángulo columna será proporcional a la frecuencia representada.

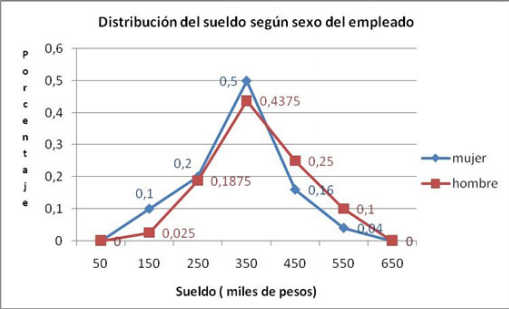
  • Polígonos de frecuencia (variables continuas): Une los puntos medios de las bases superiores de los rectángulos. Se acostumbra a prolongar el polígono hasta puntos de frecuencia cero. Un polígono de frecuencia permite ver con gran claridad las variaciones de la frecuencia de una clase a otra. Son muy útiles cuando se pretende comparar dos o más distribuciones, ya que, así como es difícil representar dos o más histogramas en un mismo gráfico, resulta muy sencillo hacerlo con dos o más polígonos de frecuencias. La suma de las áreas de los rectángulos de un histograma es igual al área limitada por el polígono de frecuencias y el eje X. El polígono de frecuencias resume, en una sola línea, el resultado del histograma correspondiente.

Los histogramas y los polígonos de frecuencia pueden representarse en una misma gráfica: 

  • Gráfico de tronco y hojas (variables continuas): Representación de la variable cuantitativa continua (ejemplo Talla). En la primera columna se representan los tallos (que corresponden en nuestro caso al primer dígito). En la segunda las hojas (en este caso el segundo dígito). Es un diagrama híbrido entre una tabla (información ordenada) y una gráfica (parecida al histograma). Tiene la ventaja de no perder información individual, identifica la distribución de los datos (posible media y mediana) y si existen clases faltantes. Esto hace que para muchos autores sea la representación gráfica de elección. Es un híbrido entre tabla e histograma: nos muestra la forma de la distribución y los valores de la variable. Cada dato de la serie se divide en dos partes: el tronco (decenas) y la hoja (unidades). 

- DATOS BIDIMENSIONALES Y MULTIDIMENSIONALES: 
  • Tendencias temporales 


  • Nubes de puntos (scatter plot): Para representar el comportamiento de dos variables continuas en un grupo de individuos. En el eje “x” se representa la variable independiente y en el eje “y” los valores de la variable dependiente. La imagen del diagrama nos da una posible idea de la correlación entre las dos variables.

La correlación de los puntos puede ser:

  • Otros gráficos multidimensionales (diagramas de estrellas…): Para representar un conjunto de variables cuantitativas y comparar entre diferentes unidades de análisis (individuos o conglomerados). ü Cada variable representa un vértice del diagrama de estrella . Gráficamente da una idea del comportamiento conjunto de las variables estudiadas. También permite comparativas con un “gold standard”. 


viernes, 15 de mayo de 2020

BLOQUE TEMÁTICO 2. TEMA 5: ESTADÍSTICOS UNIVARIABLES: MEDIDAS RESUMEN PARA VARIABLES CUANTITATIVAS

ÍNDICE
  1. Resumen numérico de una serie estadística
  2. Medidas de tendencia central
  3. Medidas de posición
  4. Medidas de dispersión
  5. Distribuciones normales
  6. Medidas de Forma (Asimetrías y Curtosis)

1. Resumen numérico de una serie estadística
Además de las tablas podemos resumir una serie de observaciones mediante “estadísticos”: “Función de los datos observados”. Hay tres grandes tipos de medidas estadísticas:
  • Medidas de tendencia central: dan idea de los valores alrededor de los cuales el resto de los datos tienen tendencia a agruparse. = MEDIA, MEDIANA Y MODA.
  • Medidas de posición: dividen un conjunto ordenado de datos en grupos con la misma cantidad de individuos. CUARTILES, DECILES Y PERCENTILES.
  • Medidas de dispersión o variabilidad: dan información acerca de la heterogeneidad de nuestras observaciones = RANGO, DESVIACIÓN MEDIA, VARIANZA, DESVIACIÓN TÍPICA, COEFICIENTE DE VARIACIÓN.
2. Medidas de tendencia central
- Media aritmética o media: Se calcula para variables cuantitativas y se trata del centro geométrico o de gravedad de nuestros datos. Es la suma de todos valores de la variable observada entre el total de observaciones. Es la medida más calculada y utilizada en estadística descriptiva. 


* Propiedades de la media:
  1. La suma de las desviaciones respecto de la media es igual a cero.
  2. La media no se altera por una transformación lineal de escala: a) Si a un conjunto de datos cuya media es X, se le suma a cada dato una constante K, la media aumenta en K unidades b) Si en un conjunto de datos cuya media es X, se multiplica cada dato por una constante K, la media queda multiplicada por K.
  3. Es muy sensible a las puntuaciones extremas.
* Otras medias:
  • Media geométrica (G): raíz N-ésima del producto de los N valores observados. 

  • Media armónica (H): inverso de la media aritmética de los inversos de los valores de la variable.

  • Media aritmética ponderada (x): media aritmética de la suma del producto de cada valor por el peso o relevancia asignada al mismo. 

- Mediana:  es la puntuación que ocupa la posición central de la distribución. Para poder hallarla necesitamos que nuestros datos estén ordenados, de forma creciente o decreciente. Es el valor de la observación tal que un 50% de los datos es menor y otro 50% es mayor. Si la media y la mediana son iguales, la distribución de la variable es simétrica. A diferencia de la media aritmética, la mediana es más robusta y menos sensible a los valores extremos. Cuando la muestra posee muy pocos datos, o existen valores extremos o datos censurados-truncados, debemos calcular siempre la mediana. Si el número de observaciones es impar el valor de la observación será justamente la observación que ocupa la posición (n+1)/2. Si el número de observaciones es par, el valor de la mediana corresponde a la media entre los dos valores centrales, es decir, la media entre la observación n/2 y la observación (n/2)+1.

- Moda: Es el valor con mayor frecuencia (que más veces se repite). Las distribuciones que contienen una sola moda se llaman unimodales. Si hay más de una se dice que la muestra es bimodal (dos modas) o multimodal (más de dos). Se puede calcular para cualquier tipo de variable. Es la medida de tendencia central menos empleada. En una distribución unimodal simétrica, los valores de la media aritmética, mediana y moda coinciden. Si los datos están agrupados, se habla de clase modal y corresponde al intervalo en el que el cociente entre la frecuencia relativa y la amplitud es mayor (hi/ci). 

3. Medidas de posición
Cuantiles: Se calculan para variables cuantitativas y, al igual que la mediana, sólo tienen en cuenta la posición de los valores en la muestra. Se define el cuantil de orden “n” como un valor de la variable por debajo del cual se encuentra una frecuencia acumulada n. Los cuantiles más usuales son los percentiles, los deciles y los cuartiles, según dividan la muestra ordenada en 100, 10 ó 4 partes, respectivamente.
  • Percentiles: Dividen la muestra ordenada en 100 partes. Los percentiles son los 99 puntos o valores que dividen la distribución en cien partes iguales. Se representan por P(n). El percentil “i” (Pi), es aquél valor que, ordenadas las observaciones en forma creciente, el i% de ellas son menores que él y el (100-i)% restante son mayores. Para buscar la posición de un percentil en una serie de datos agrupados, buscamos el intervalo en el que la frecuencia relativa acumulada (Hi) sea superior al valor del percentil. El valor del P50 corresponde al valor de la mediana.

  • Deciles: Dividen la muestra ordenada en 10 partes. Los deciles son los nueve valores que dividen a la distribución en diez partes iguales. Cada parte incluye el 10% de los valores de la distribución. Se representan por la letra D. – El decil “i” (Di), es aquél valor que, ordenadas las observaciones en forma creciente, el i/10% de ellas son menores que él y el (100-i)/10% restante son mayores. El valor del D5corresponde al valor de la mediana y, por tanto, al del P50.
  • Cuartiles: Dividen la muestra ordenada en 4 partes. Son los tres valores que dividen la distribución en cuatro partes iguales, cada parte incluye el 25% de los valores de dicha variable. Se representan por Q1, Q2 y Q3. El Q1, primer cuartil indica el valor que ocupa una posición en la seria numérica de forma que el 25% de las observaciones son menores y que el 75% son mayores. El Q2, segundo cuartil indica el valor que ocupa una posición en la seria numérica de forma que el 50% de las observaciones son menores y que el 50% son mayores. Por tanto, el Q2 coincide con el valor del D5, con al valor de la mediana P50. El Q3, tercer cuartil indica el valor que ocupa una posición en la seria numérica de forma que el 75% de las observaciones son menores y que el 25% son mayores. El Q4, cuarto cuartil indica el valor mayor que se alcanza en la seria numérica.

4. Medidas de dispersión
- Rango o recorrido (R): Es la medida de dispersión más simple y consiste en tomar la puntuación mayor y restarle la puntuación menor. Es el recorrido de una variable. La principal limitación del rango es que al tener en cuenta solamente los valores más alto y más bajo, se ve dramáticamente afectado por los valores extremos. Recorrido intercuartílico (RI): Diferencia entre el tercer y el primer cuartil= |Q3- Q1|.

- Rango Semiintercuartil: También conocido como desviación cuartil, o espectro semicuartil. En su cálculo utiliza los valores intermedios y no extremos, lo que le confiere mayor estabilidad que el rango. 

- Desviación media (DM): Es la media aritmética de las distancias de cada observación con respecto a la media de la muestra.


- Varianza (S2): Es la media de los cuadrados de las diferencias entre cada valor de la variable y la media aritmética de la distribución. 

Siempre tiene un valor positivo Se mide en unidades de la variable estudiada (al cuadrado). Cuanto menor sea la varianza mayor homogeneidad y menor dispersión. Denominador de la varianza: n para la muestra (s2) y n-1 para la población: varianza insesgada o cuasivarianza.

- Desviacion típica o estándar (S): Expresa la dispersión de la distribución mediante un valor que siempre es positivo y en las mismas unidades de medida de la variable, siendo la medida de dispersión más utilizada en estadística descriptiva. Cuando los datos están muy alejados de la media, el numerador será grande y la varianza y la desviación típica también lo serán. Al aumentar el tamaño de la muestra, disminuye la varianza y la desviación típica.


* Propiedades: 
  1. La desviación típica será siempre un valor positivo o cero, en el caso de que las puntuaciones sean iguales. 
  2. Si a todos los valores de la variable se les suma un número la desviación típica no varía. 
  3. Si todos los valores de la variable se multiplican por un número la desviación típica queda multiplicada por dicho número.
* Observaciones de la desviación típica 
  1. La desviación típica, al igual que la media y la varianza, es un índice muy sensible a las puntuaciones extremas. 
  2. En los casos que no se pueda hallar la media tampoco será posible hallar la desviación típica.
  3. Cuanta más pequeña sea la desviación típica mayor será la concentración de datos alrededor de la media.
- Coeficiente de variación (CV): También recibe el nombre de variabilidad relativa, puesto que es una medida de dispersión relativa de los datos. Se calcula dividiendo la desviación típica entre la media de la muestra, y expresado en porcentaje. El CV es un medida adimensional y nos permite comparar la dispersión o variabilidad de dos o más grupos. Sin embargo, no debe usarse cuando la variable presenta valores negativos o donde el valor 0 sea una cantidad fijada arbitrariamente.

5. Distribuciones normales
En estadística se llama distribución normal, distribución de Gauss o distribución gaussiana, a una de las distribuciones de probabilidad de variable continua que con más frecuencia aparece en fenómenos reales. La gráfica de su función de densidad tiene una forma acampanada y es simétrica respecto de los valores posición central (media, mediana y moda, que coinciden en estas distribuciones). Esta curva se conoce como campana de Gauss.


6. Medidas de Forma (Asimetrías y Curtosis)
Las medidas de forma indican si la distribución es simétrica (coeficiente de sesgo) y el grado de apuntamiento, tomando siempre como referencia la curva normal.


- Asimetrías: Coeficiente de asimetría de una variable: Grado de asimetría de la distribución de sus datos en torno a su media. Las distribuciones asimétricas también se llaman sesgadas, y se caracterizan porque el pico de la misma se encuentra descentrado (no simétrica), apareciendo una cola más larga que la otra. Es adimensional y adopta valores entre -1 y 1.
Interpretación del coeficiente de asimetría: 

  • g 1 = 0 (distribución simétrica; existe la misma concentración de valores a la derecha y a la izquierda de la media).

  • g1 > 0 (distribución asimétrica positiva; La cola de la distribución es más larga hacia la derecha y los valores más elevados quedan a la izquierda).


  • g1 < 0 (distribución asimétrica negativa; La cola de la distribución es más larga hacia la izquierda y los valores más elevados quedan a la derecha).


- Curtosis o apuntamiento: Coeficiente de apuntamiento o curtosis de una variable, sirve para medir el grado de concentración de los valores que toma en torno a su media. Se elige como referencia una variable con distribución normal, de modo que para ella el coeficiente de curtosis es 0. Adopta también valores entre -1 y 1. Es una medida adimensional.
Los resultados pueden ser los siguientes: 


  • g 2 = 0 (distribución mesocúrtica). Presenta un grado de concentración medio alrededor de los valores centrales de la variable (el mismo que presenta una distribución normal). 

  • g2 > 0 (distribución leptocúrtica ). Presenta un elevado grado de concentración alrededor de los valores centrales de la variable. 


  • g2 < 0 (distribución platicúrtica). Presenta un reducido grado de concentración alrededor de los valores centrales de la variable.


BLOQUE TEMÁTICO 2. TEMA 4: INTRODUCCIÓN A LA ESTADÍSTICA DESCRIPTIVA

ÍNDICE

  1. Estadística descriptiva
  2. Estadística inferencial
  3. Variables (presentación de datos)
  4. Variables continuas (tablas de frecuencias datos agrupados)
  5. Indicadores/ concepto de indicador
  6. Medidas de asociación: relaciones entre proporción, ratios y odds

1. Estadística descriptiva
Sirve para describir y resumir datos. Es el tipo de estadística que normalmente se usa en los medios de difusión. Describe y analiza una determinada población o muestra sin pretender sacar conclusiones de tipo general. También describe, analiza y representa un grupo de datos utilizando métodos numéricos y gráficos que resumen y presentan la información contenida en ellos. Además organiza de manera clara y fácil de analizar, resume los datos y explora las relaciones entre variables. Este tipo de estadística es preliminar antes que la inferencia. 

2. Estadística inferencial
Utiliza muestras de datos para sacar conclusiones sobre poblaciones más grandes. Este tipo de método se encuentra más frecuentemente en artículos publicados sobre investigación científica. Infiere o “induce” leyes de comportamiento de una población, a partir del estudio del análisis de una muestra. Apoyándose en el cálculo de probabilidad y a partir de datos muestrales, efectúa: estimaciones, decisiones, predicciones y generalizaciones sobre un conjunto mayor de datos.

3. Variables (presentación de datos)
Las tablas de frecuencia se realizan con datos que muestran frecuencias en columnas y las categorías de las variables en las filas. Presentan información repetitiva de forma visible y comprensible. Sus requisitos son:
  • Son autoexplicables
  • Son sencillas y de fácil comprensión
  • Tienen un título breve y claro
  • Indican lugar, fecha y fuente de información
  • Incluye las unidades de medida en cada cabecera
  • Indican frecuencias absolutas y relativas
* Tabla de frecuencia variable cualitativa dicotómica (ejemplo)


* Tabla de frecuencia variable cualitativa policotómica (ejemplo)


* Tabla de frecuencia variable cualitativa ordinal (ejemplo)


* Tabla de frecuencia variable cuantitativa discreta (ejemplo)


4. Variables continuas (tablas de frecuencias datos agrupados)
  • Definición de intervalos 
  • Definición de extremos de los intervalos
  • Definición de amplitud o distancia entre los extremos 
  • Cálculo de la marca de clase de cada intervalo
  • Frecuencias absolutas (𝒇𝒊 ): número de individuos que presentan una modalidad, o que están incluidos en un intervalo.
  • Frecuencias relativas (𝒉𝒊 ): proporción de individuos referidos al total que presentan una modalidad o que están incluidos en un intervalo.
  • Frecuencias acumuladas ( 𝒇𝒊 ó 𝒉𝒊 ): número de individuos menores o iguales que la modalidad o el intervalo que estamos estudiando.

Ejemplo

5. Indicadores/ concepto de indicador
En el análisis descriptivo se usan en gran medida los números relativos, que son la expresión de la relación de dos o más cantidades. La frecuencia absoluta no puede ser un indicador pues le falta un denominador que la relacione con el tamaño de la muestra o población, y/o el periodo en el que se presentaron los eventos. Los indicadores siempre están formados por un numerador y un denominador, es decir, es el resultado del cociente entre dos magnitudes. Un indicador es la medida de la frecuencia de un determinado suceso en una población, expresado como un número que puede ser: 

- Proporción: medida resumen para variables cualitativas, que consiste en la comparación, a través de un cociente (división) entre un subconjunto y el conjunto al que pertenece. El numerador siempre está incluido en el denominador. Adopta valores reales entre 0 y 1, expresando la frecuencia relativa del suceso que medimos. Se suele multiplicar por 100, para una mejor comprensión, expresando los porcentajes correspondientes. Si el suceso que medimos es muy poco frecuente, podemos multiplicar por 1.000, por 10.000, etc.

- Tasa: medida que expresa el riesgo de ocurrencia del evento (enfermedad) estudiado. En realidad es una proporción, pero con relación espacial y temporal. El denominador incluye una unidad de tiempo. Consiste en la comparación, a través de una división, entre el número de veces que ocurre un cierto tipo de evento y la población en la que puede ocurrir dicho evento en un tiempo determinado. Usualmente el resultado de tal división consiste en una cifra fraccionaria menor a 1, por lo que el resultado suele ser multiplicado por alguna constante que sea múltiplo de 10.

* Medidas más empleadas en estadística sanitaria
Según lo que queremos medir: 
- La situación en un punto en el tiempo: PREVALENCIA: Describe qué proporción de la población tiene la enfermedad en un punto específico en el tiempo: Depende de la velocidad de aparición de la enfermedad (incidencia) y de su duración. Características: es adimensional y adopta valores entre 0 y 1 (es una proporción).

- Lo que está pasando durante un periodo de tiempo: INCIDENCIA. Describe la frecuencia de NUEVOS CASOS que ocurren durante un periodo de tiempo. Es el flujo de sanos a enfermos, mide un cambio. Es una medida de riesgo. Características: es adimensional, adopta valores entre 0 y 1 (es una proporción), y si se mide como "Densidad de Incidencia", es una tasa, y adoptaría valores hipotéticos entre 0 e infinito. 
Hay dos tipos de incidencias: 
  • Incidencia acumulada (proporción de incidencia) Riesgo de que se produzca el suceso. Se calcula utilizando un período de tiempo durante el cual consideramos que todos los individuos de la población están a riesgo de la enfermedad. Es la proporción de sujetos que desarrollan la enfermedad, en un período de tiempo, del total de población a riesgo al inicio del período.  Mide el riesgo promedio de padecer la enfermedad (probabilidad de desarrollar la enfermedad).
- Mide la probabilidad de tener el evento. 
- No tiene unidades. Es una proporción (se expresa como %, %0 ... 
- Valores entre 0 y 1 [0 – 100]. 
- No lleva implícito el período de tiempo  debe expresarse siempre. 
- Condiciones: 
  • No puede haber pérdidas en el seguimiento. 
  • Se siguen a todos los sujetos durante todo el período. 
  • No permite inferir fuera del período de estudio.

  • Tasa de incidencia (densidad de incidencia): Velocidad de aparición de nuevos casos con respecto al tamaño de la población. Con frecuencia, no todos los individuos a riesgo (denominador) son seguidos durante el mismo período de tiempo. Si se disponen de los diferentes tiempos de observación (“tiempos en riesgo”) de los diferentes individuos, se puede calcular la densidad de incidencia o tasa de incidencia. Es necesario especificar la unidad de tiempo a las que se refiere la tasa (se mide en unidades de tiempo–1).Una misma cantidad de personas-tiempo se puede obtener mediante el seguimiento de distintos grupos de población.  Expresa la “tasa” o velocidad a la cual ocurren los eventos en sujetos de la población en riesgo en cualquier momento. (Tasa: datos agregados. Densidad de incidencia: tasa obtenida de datos individuales). 

Personas – tiempo:
- Suma de tiempos que los individuos están a riesgo de desarrollar el evento. 
- Las unidades a utilizar dependen del investigador. Los eventos poco frecuentes suelen describirse en personas-año o un múltiplo del mismo (100 o 1000 personas-año). En cambio en los eventos más frecuentes se pueden utilizar personas-semana o personas-día. 

* Relación entre prevalencia e incidencia

- Razón: es una medida de resumen para variables cualitativas que consiste en la comparación, a través de una división entre dos conjuntos. Los dos conjuntos son distintos, es decir, uno no incluye al otro. El numerador del cociente, por tanto, no está incluido en el denominador, como sí sucedía en las proporciones.

-Odds:  es el cociente entre la proporción o probabilidad de ocurrencia de un evento y la proporción o probabilidad (complementaria) de no ocurrencia, se denomina con el término inglés “odds”, empleado en el lenguaje de apuestas. No hay un término exacto en español, ni consenso en su traducción. El más aceptado es “ventaja” u “oportunidad”. La odds representa la frecuencia de un aspecto relativa a los sujetos que no presentan dicho aspecto, por lo que es un tipo especial de razón. Sus valores van desde 0 (eventos que nunca ocurren) hasta el infinito (eventos que ocurren siempre). Forma de cálculo: 


6. Medidas de asociación: relaciones entre proporción, ratios y odds
La magnitud de asociación entre dos fenómenos (por ejemplo entre un factor de exposición y una enfermedad), puede estimarse a través de medidas que relacionen proporciones, tasas y odds. Es lo que se llaman “MEDIDAS DE ASOCIACIÓN” y dependiendo del tipo de estudio, se usarán una u otra. Las tres más importantes son: 
  • Razón de prevalencias: Estudios descriptivos de corte transversal. Realiza una ratio entre dos prevalencias (proporciones). Es la razón entre la proporción de enfermos en los expuestos y la proporción de enfermos entre los no expuestos. Cuantifica una estimación de la asociación entre el factor de exposición y la enfermedad. Si el valor se aproxima a 1, la enfermedad se distribuye por igual entre los expuestos y los no expuestos. La relación entre la incidencia (nuevos casos) en expuestos I.e y la incidencia (nuevos casos) en no expuestos I.ne, se puede expresar como: 

  • Riesgo relativo o razón de riesgos: Estudios de observacionales de seguimiento o estudios experimentales. Realiza una ratio entre dos incidencias acumuladas (proporciones) o dos densidades de incidencia (tasas). Es la razón entre el riesgo en los expuestos y el riesgo en los no expuestos. Cuantifica el incremento en el riesgo producido por la exposición. Si el valor se aproxima a 1, la enfermedad o el suceso aparece de forma similar entre los expuestos y los no expuestos.

  • Odds ratio: Estudios de casos y controles. Realiza una ratio entre dos medidas “odds” o ventajas. Se trata de relacionar la ODDS o VENTAJA de los casos con la ODDS o VENTAJA de los controles. Toma valores > 1 =1 De 0 a 1.


domingo, 26 de abril de 2020

BLOQUE TEMÁTICO 2: ANÁLISIS DE DATOS I: DESCRIPCIÓN Y ESTIMACIÓN DE DATOS. TÉORÍA DE LA PROBABILIDAD.TEMA 3: DE LOS CONCEPTOS A LAS VARIABLES

ÍNDICE
  1. Concepto de estadística y bioestadística
  2. Clasificación de la estadística
  3. Investigación cuantitativa y cualitativa
  4. Tipos de investigación biosanitaria
  5. Procedimiento muestral
  6. Proceso de la inferencia estadística
  7. Parámetros y estadísticos
  8. Población de estudio
  9. Tipos de muestreo
  10. Cálculo del tamaño muestral
  11. Mediciones directas
  12. Mediciones indirectas
  13. Medición de signos y síntomas
  14. Escalas de medición de variables
  15. Variable


1. Concepto de estadística y bioestadística
  • Estadística: ciencia cuyo objeto es dar métodos para el tratamiento de los datos provenientes de observaciones (demográficas, económicas, biomédicas o sanitarias, etc.); donde intervienen un gran número de factores de variación.
  • Bioestadística: aplicación de la estadística en la interpretación de los fenómenos de la vida (biología, salud, etc.) donde la variabilidad supone el carácter esencial (Carrasco, 1995).
2. Clasificación de la estadística
  • Bioestadística Descriptiva o Deductiva: se ocupa del tratamiento, resumen y presentación de los datos observados de una manera gráfica y científica.
  • Bioestadística Inferencial o Analítica: su objetivo es “inferir”, o sea, establecer conclusiones sobre una población a partir de los resultados obtenidos de una muestra, todo ello, con un determinado nivel de seguridad o intervalo de confianza.
3. Investigación cuantitativa y cualitativa
Es una serie ordenada de procedimientos o etapas, regido por principio y reglas, y cuyo objetivo principal es obtener explicaciones válidas de los fenómenos observados. Tiene:
- Mayor objetividad
- Mayor capacidad de predicción
- Mayor control
- Mayor generalización
Combina el razonamiento inductivo (establecer generalizaciones a partir de observaciones particulares), el razonamiento deductivo (realizar predicciones particulares a partir del conocimiento de resultados generales) y la evidencia empírica o práctica (hace referencia a la realidad objetiva y reunida, ya sea de forma directa o indirecta, a través de los sentidos).


4. Tipos de investigación biosanitaria
  • Investigación cuantitativa: basada en la recogida sistemática de información numérica y en el análisis estadístico. Descansa en el razonamiento deductivo y en las reglas de la lógica y ancla sus raíces en el positivismo lógico.
  • Investigación cualitativa: subraya los aspectos dinámicos, holísticos e individuales de la experiencia humana y trata de captar cada uno de estos aspectos en su totalidad y dentro del contexto de quienes lo viven. Esta técnica de investigación evita la cuantificación y su método descansa en la recogida de información subjetiva a través de técnicas como las entrevistas no estructuradas, la observación participantes, los registros narrativos, etc.

5. Procedimiento muestral
Un muestreo es un método tal que al escoger un grupo pequeño de una población podamos tener un grado de probabilidad de que ese pequeño grupo posea las características de la población que estamos estudiando.


6. Proceso de la inferencia estadística
La inferencia estadística estudia como sacar conclusiones generales para toda la población a partir del estudio de una muestra, y el grado de fiabilidad o significación de los resultados obtenidos.

Vídeo explicativo sobre la inferencia estadística: https://www.youtube.com/watch?v=nbJU4iS-LEg

7. Parámetros y estadísticos
Parámetros
  • Es una cantidad numérica calculada sobre una POBLACIÓN o UNIVERSO cuyo tamaño se expresa con N (mayúscula).
  • La idea es resumir toda la información que hay en la población en unos pocos números (parámetros).
  • Los parámetros se expresan con letras griegas: σ (desviación típica), π (proporción), µ (media), etc.

Estadísticos
  • Es una cantidad numérica calculada sobre una MUESTRA extraída de la POBLACIÓN o UNIVERSO, cuyo tamaño se expresa con “n” (minúscula).
  • La idea es resumir toda la información que hay en la población en unos pocos números (estimadores).
  • Los parámetros se expresan con letras latinas en minúsculas: s (desviación típica), p (proporción), x (media), etc.

8. Población de estudio
Conjunto infinito o finito de elementos definidos por una o mas característica de las que gozan todos los elementos que la componen y solo ellos. Ej.: estudiantes de enfermería, personas diabéticas….

Niveles de población 
  • Población diana: Conjunto de individuos que presenta la característica a estudiar.
  • Población de estudio: Subconjunto de individuos que cumplen criterios de inclusión.
  • Muestra: parte de la población de estudio con la que se trabaja o investiga.
  • Participantes: los individuos reales que han participado.
Representatividad de la población
  • Tamaño: Suficientemente grande para ser representativa y pequeña para facilitar el análisis de los datos.
  • Comparable: GI /GC comparables.
9. Tipos de muestreo

- Muestreo Probabilístico: Todas las unidades que componen la población tienen una probabilidad de ser elegidas y se puede calcular de antemano. Hay distintos tipos: 
  • Muestreo Aleatorio: Hay dos tipos: Simple: seleccionar al azar (tabla numero / pc) la n (muestra). Se usa poblaciones pequeñas. El mas representativo. Desventajas: listados todas las unidades / costos por dispersión población / grupos minoritarios no representados. Sistemático: seleccionar individuos según una regla o proceso. Fórmula: K= N/n r= 1 y K (N: población candidata / n: muestra). Ventajas: no hace falta tener la lista completa.
  • Muestreo Estratificado: Se utiliza cuando la característica objeto de estudio no se distribuye de forma homogénea en la población, pero existen grupo o estrato donde se si presenta de manera homogénea. Estos grupos tienen alguna característica en común pero son mutuamente excluyentes. Ventaja: conocer como se comporta una variable en cada subgrupo de la población con precisión. Desventaja: necesita mas información y un listado de cada individuo de la población.
  • Muestreo Conglomerados:  Se obtiene de grupos o conglomerados ya establecidos cuando no hay listado de la población. Se usa cuando hay poblaciones muy dispersas o no hay listado completo individuos pero si de los grupos (unidades de un hospital). Desventaja: no se conoce de antemano el tamaño de la muestra que se va a obtener ya que el tamaño depende de los grupos seleccionados. Necesita un mayor tamaño de la muestra para ser preciso.


- Muestreo no Probabilístico: Las unidades que componen la población tienen diferente probabilidad de ser elegidas ya que no solo interviene el azar sino también otras condiciones. No se puede calcular la probabilidad de antemano y no todos los elementos tienen alguna posibilidad de ser incluidos. (dudosa representatividad).
  • Muestreo Consecutivo: El más utilizado. Si se hace bien puede ser la representatividad de la muestra puede ser semejan al del muestreo probabilístico. Se recluta a todos los individuos de una población que son accesibles y que cumplen los criterios de inclusión durante un periodo de reclutamiento fijado. Desventajas: Que no se haga de forma enteramente consecutiva sino que haya interrupciones. Periodo de reclutamiento corto o que haya fluctuaciones.
  • Muestreo de conveniencia: Se recluta a los individuos que son mas accesibles para el equipo investigador o que se presentan voluntariamente. Se usa con frecuencia al ser el menos costoso y mas fácil. Desventaja: Poco sólida ya que requiere de una gran homogeneidad de la variable estudiada en la población. Genera sesgos importantes.
  • Muestreo intencional: El propio investigador es quien selecciona a los individuos al considerarlo los mas apropiados. Se usa cuando se quiere contar con una muestra de expertos o en estudios cualitativos. Desventaja: Este método puede no contar con un método externo y objetivo para valorar la idoneidad de los sujetos.
  • Muestreo bola de nieve: El propio investigador elige a un participante que cumpla los criterios de inclusión y al mismo tiempo se le pide que identifique a otros individuos con sus mismas características para invitarles a participar y así sucesivamente hasta que se tenga recogida la muestra. Muy utilizada en estudios cualitativos. Ventaja: se puede acceder a parte la población con difícil acceso o difíciles de identificar (poblaciones marginadas como sectas). Desventaja: La muestra puede ser reducida debido a la reducida red de contactos. Calidad de los participantes condicionada por la invitación de otros a confiar en el investigador.
  • Muestreo teórico: la selección de la muestra se hace de forma gradual debido a que el propósito del estudio es la generación de una teoría o porque la integración de la muestra se va diciendo sobre la marcha. Los participantes deben cubrir todas las características, perfiles y patrones que puedan influir de el fenómeno estudiado. Ventaja: se puede acceder a parte la población con difícil acceso o difíciles de identificar (poblaciones marginadas como sectas). Desventajas: La muestra puede ser reducida debido a la reducida red de contactos. La calidad de los participantes condicionada por la invitación de otros a confiar en el investigador.
10. Cálculo del tamaño muestral

Determinar el numero aproximado de sujetos que es necesarios incluir en la muestra para que esta sea representativa. Si no hacemos un calculo correcto puede ocurrir:
- Que nos falten sujetos de estudio. Nos faltaría precisión en estimar los parámetros de estudio y no seriamos encontraríamos diferencias significativas cuando si las hay. Error tipo II.
- Que estudiemos a mas sujetos de los necesarios. Gasto de tiempo y recursos. Saturación de la muestra y no garantiza representatividad si no se ha hecho un muestreo probabilístico.
El tamaño de la muestra puede depender: 
  • Variabilidad el parámetro que se quiere estudiar o medir: + frec = muestra pequeña.
  • La precisión con la que queremos dar los datos: + precisión menor intervalo de confianza. Error estándar.
  • Nivel de confianza o significación estadística: En ciencias de la salud = 95% (ejemplo: dieta hiposódica para HTA).
  • Poder estadístico o potencia estudio: Capacidad de un estudio de encontrar diferencias si las hay.
  • Efecto esperado: Dependerá del efecto de la intervención que se lleva a cabo en los ensayos clínicos. Nos basamos en bibliografía previa. A mayor efecto esperado menor muestra necesaria.
11. Mediciones directas
Son las realizadas a elementos concretos como:

  • Altura
  • Temperatura 
  • Ritmo cardíaco 
  • Peso 
  • Respiración 
  • Glucemia

Las enfermeras también tienen experiencia en recoger medidas directas de variables atributivas o demográficas como:
  • Edad 
  • Género 
  • Origen étnico 
  • Estado civil 
  • Nivel de ingresos 
  • Nivel educativo
12. Mediciones indirectas
En investigación enfermera, muy a menudo la característica que el investigador tiene que medir es una idea abstracta o subjetiva como: 

  • Estrés 
  • Cuidado 
  • Ansiedad 
  • Dolor 
  • Afrontamiento. Inidicadores de afrontamiento: frecuencia o exactitud de la identificación del problema, tiempo o eficacia en la resolución del problema, nivel de optimismo y tipos de comportamiento de autoactualización.
Raramente una estrategia de medición puede medir todos los aspectos de un concepto abstracto.


13. Medición de signos y síntomas
Diferentes naturalezas de las variables, diferentes métodos de medición. Por ejemplo: la presencia de dolor se puede medir como “sí” o “no”, sin embargo la glucemia basal se tendrá que medir por mg de glucosa por dl de sangre, con valores que pueden ir de 0 a 1000 mg/dl, por ejemplo. Son variables de diferente naturaleza. Para medir variables se utilizan diferentes escalas de medición.

14. Escalas de medición de variables

  • Escalas nominales o clasificatorias: Nivel más bajo de medición. Los datos se ajustan por categorías que no mantienen una relación de orden entre sí (ej: color de los ojos). En una característica o variable sólo se puede comprobar si son iguales o diferentes. Los números se utilizan como meros nombres, podrían ser sustituidos por símbolos, letras. Estos números no gozan de ninguna de las propiedades aritméticas. Las categorías deben ser exhaustivas y mutuamente excluyentes. Ej: Género (1. Hombre. 2. Mujer).
  • Escalas ordinales o de rango: Aporta información referente a la equivalencia y existe un cierto orden o jerarquía entre las categorías (ej: grados de disnea). En la medición ordinal dadas dos o más modalidad de una variable, es posible: establecer si son iguales o diferentes, y si son distintas, determinar cual es la mayor. Por lo tanto, los números expresan relaciones de igualdad, desigualdad y orden. Ej: Grado de mejoría tras el tratamiento: (1.Nula 2.Leve 3.Media 4.Máxima). Características
- No podemos establecer la cantidad de mejoría diferencial que un nivel, categoría o número representa en relación a cualquier otro. 
- Carecemos de suficiente información para determinar si entre los niveles 3 y 4 existe el mismo grado de mejoría que entre el 3 y 2 ó 2 y 1. 
- No se puede afirmar que la categoría 4 sea el doble que 2.
- Sólo podemos un orden, una jerarquía 4 > 3 > 2>1.
  • Escala de intervalo: los datos tienen que ser numéricos y poseen las propiedades de la escala ordinal. Los intervalos entre observaciones se expresan en términos de una unidad de medición fija (ej: temperatura). Presenta la características propias de las dos escalas anteriores: IDENTIDAD Y ORDEN + requerimiento de que las distancias o intervalos iguales representan distancias equivalentes. Ej: temperatura: (36º, 37º, 38º. El 0 no representa ausencia de calor, sin embargo, cualesquiera La distancia entre de los puntos de la escala es igual. El Cambio de temperatura entre 36º y 37º = al cambio de temperatura entre 40º y 41º.). Características:
- No puede sacar razones o proporciones. No podemos afirmar que 20º es el doble de 10º.
- Escala cuantitativa y en ella se puede aplicar las estadísticas como mediana, desviaciones y correlación.
  • Escala de proporción o racional: Supone el nivel más alto de medición. Se utiliza cuando una escala tiene todas las características de una escala de intervalo, y además tiene un punto cero real en su origen (ej: peso en gramos). Por lo tanto, tiene las características propias de las tres escalas anteriores: identidad (Igualdad, desigualdad), orden, distancias equivalentes entre los intervalos + la ventaja adicional de poseer el 0 absoluto, en la que el 0 representa nulidad o ausencia de lo que se estudia. Entre dos números atribuidos a las modalidades admitiremos como validas: Las relaciones de identidad + orden + la existencia de intervalos equivalentes y cuantas veces una modalidad es superior a otra. Por tanto, en 2 números atribuidos a dos modalidades se admitirán como válidas las relaciones de: identidad; orden; las operaciones de suma, resta, multiplicación y división. Ej: edad, peso, talla, número de alumnos etc.
15. Variable
Característica que puede ser medida en la muestra o población y que puede variar de un sujeto a otro, o bien, de un evento a otro (de ahí su nombre). Datos: Cada uno de los valores que puede tomar la variable. 

* Tipos de variables:
- Variables Cuantitativas: Pueden tomar un valor numérico. Ej. Talla, nivel de colesterol, número de hijos, peso, etc.
  • Discretas: Sólo pueden tomar un número finito de valores dentro de un intervalo y se pueden asimilar a los números enteros. Ejemplos: el número de hijos.
  • Continuas: Aquellas que pueden tomar infinitos valores dentro de intervalo, incluyendo decimales. Ejemplos: Peso, talla, glucemia basal…
- Variables Cualitativas: También llamadas atributos, factores, variables categóricas, variables nominales, etc. Toman valores no numéricos y por tanto, no son susceptibles de cuantificarse. Sirven para medir cualidades. Ej. Estado civil, nivel de estudios, color de ojos, factor Rh… 
  • Dicotómica o binaria. Sólo puede tomar dos valores opuestos y además excluyentes. Ejemplos: hombre/mujer, presente/ausente, enfermo/sano. 
  • Policotómica: Puede tomar más de dos valores o atributos. Pueden ser ordinales o nominales. Pueden ser: Cuali policotómicas oridinales: nivel de estudios (sin estudios, primarios, secundarios, universitarios) o Cuali policotómicas nominales: estado civil, servicios de ingreso hospitalario, antecedentes laborales, etc.
* Operativización de las variables:
Es el proceso que transforma una variable subjetiva o abstracta en otras variables indirectas que tengan el mismo significado y que sean susceptibles de medición. Consiste en descomponer las variables principales en otras más específicas llamadas dimensiones. A su vez es necesario traducir las dimensiones en indicadores que permitan la observación directa.